

不用翻设置页了!openKylin 3.0 系统控制背后的三级识别
在 OpenAtom openKylin (以下简称“openKylin”) 小 K 助手里,有一项用起来很顺手的能力:你说“把亮度调高一点”“打开文件管理器”“设个明早七点的闹钟”,系统听懂后直接完成对应的操作,不用一层层翻设置界面。
这项能力基于开源的 kylin-ai-runtime 运行时实现——它是小 K 助手的开源运行时,负责对话、识别、推理等后台工作,系统控制是其中面向系统的部分。对用户来说,最直观的感受是“说了就能办成”;对开发者来说,更有意思的是这条链路是如何实现的。下面以 openKylin 3.0 所载版本为例,看看系统控制覆盖哪些能力,以及“听懂一句话”是怎么实现的。
能做什么:操作范围一览
系统控制覆盖日常最常用的几类操作:显示(亮度、缩放、色温护眼)、声音(音量、音效)、电源与任务栏、鼠标键盘与触控板、网络连接、应用启动与关闭、闹钟与日程等。具体支持哪些操作随系统版本和部署配置而定,还在持续扩充。
使用方式很直接,不需要背命令格式、菜单层级,按平常说话即可,例如:
- “把屏幕亮度调高一点”
- “音量调到 60”
- “熄屏后打开需要密码”
- “打开文件管理器”
- “设置一个明早七点的闹钟”
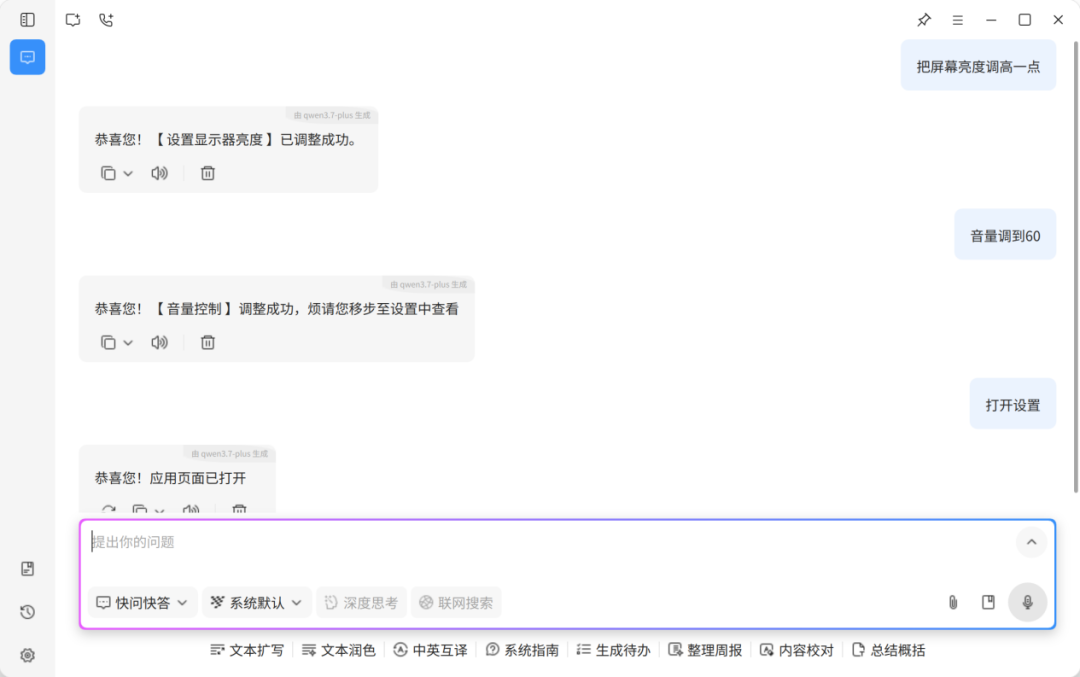
系统会先判断你想做什么,再补上需要的细节,一轮对话内完成。
怎么听懂:三级递进识别
把一句自然语言变成一次可执行的操作,核心是两步:先判断用户想做什么(意图识别),再补齐操作所需的信息(参数抽取)。
kylin-ai-runtime 采用三级递进的方案,按成本从低到高依次尝试,哪一级得到可靠结果就停在哪一级:
三级识别共用同一种输出格式,上层逻辑无需区分请求来自哪一级。
整条链路的组织可以概括为下面这张图:

之所以拆成三级,是因为不同表达对系统的要求差别很大。固定说法用规则匹配最快、最省资源;口语变体需要语义能力来兜住覆盖面;少数绕弯或省略的说法,则要更强的模型来补全。三级方案本质上是用递增的成本去匹配表达的复杂性,常用指令足够快,冷门说法也不落空。
听懂之后:确认补全再执行
意图识别只回答了“做什么”,多数操作还需要知道“做到什么程度”。比如意图是调音量,但目标音量是多少?
系统为每类操作定义了可接受的取值:任务栏位置限定在左、右、上、下几个选项;音量既接受“调高”“调低”“最大”“静音”,也支持 0 到 100 的数值。信息缺失或含糊时,系统会先确认,而不是猜着执行。
比如你说“帮我把音量调一下”,系统会问“您想调到多少?”,得到明确答复后再动手。整个交互就是一轮自然对话,用户不需要知道后台的分级识别,也不用自己去设置里翻开关。
怎么取舍:四个设计选择
实现过程中几个设计选择值得说明:
本地优先。识别链路的关键环节可以在端侧完成,不依赖网络,也避免把用户表达发送到外部服务;是否接入云端由部署方决定。
规则与模型互补。固定表达用匹配保证稳定、可预期;语义检索和大模型负责覆盖说法变化。两者共享同一套输出格式,后续流程不区分请求来自哪一级。
可配置。关键词口令、可操作的应用清单、提示词等都存放在配置文件中,调整识别行为不需要修改代码,也方便不同发行版和社区版本按需适配。
识别与执行分离。识别结果需要经过确认才可能触发操作,系统对没有把握的请求保持克制,宁可先澄清,也不贸然改动系统状态。
如何参与
系统控制的能力定义、识别规则、提示词和实现代码都随 kylin-ai-runtime 开源发布,仓库地址:
https://gitee.com/openkylin/kylin-ai-runtime
想读懂实现的同学,可以从“意图识别”和“系统操作执行”两个模块入手;使用中发现识别不准的说法,可以直接在配置文件里补充规则、调整口令,适配自己的发行版或使用环境;也欢迎到仓库提 issue、提 PR,或加入维护 AISubsystem SIG(AI 子系统兴趣小组),参与 openKylin AI 子系统的建设。